사진 속 폐기물을 찾아 6종으로 분류하는 AI 서비스를 공개 주소로 올렸습니다. 별도 서버 없이 맥북 한 대에서 학습하고, 같은 맥북에서 서비스까지 돌립니다. 이 글은 성능 수치보다 구조를 다룹니다. 데이터가 모델이 되는 과정, 사진 한 장이 답이 되는 과정, 그리고 두 흐름이 다시 이어지는 방식입니다.
현재 운영 구성
학습 과정: 기준을 맞추고, 섞이지 않게 나누고, 결과가 같은 곳에서 잰다
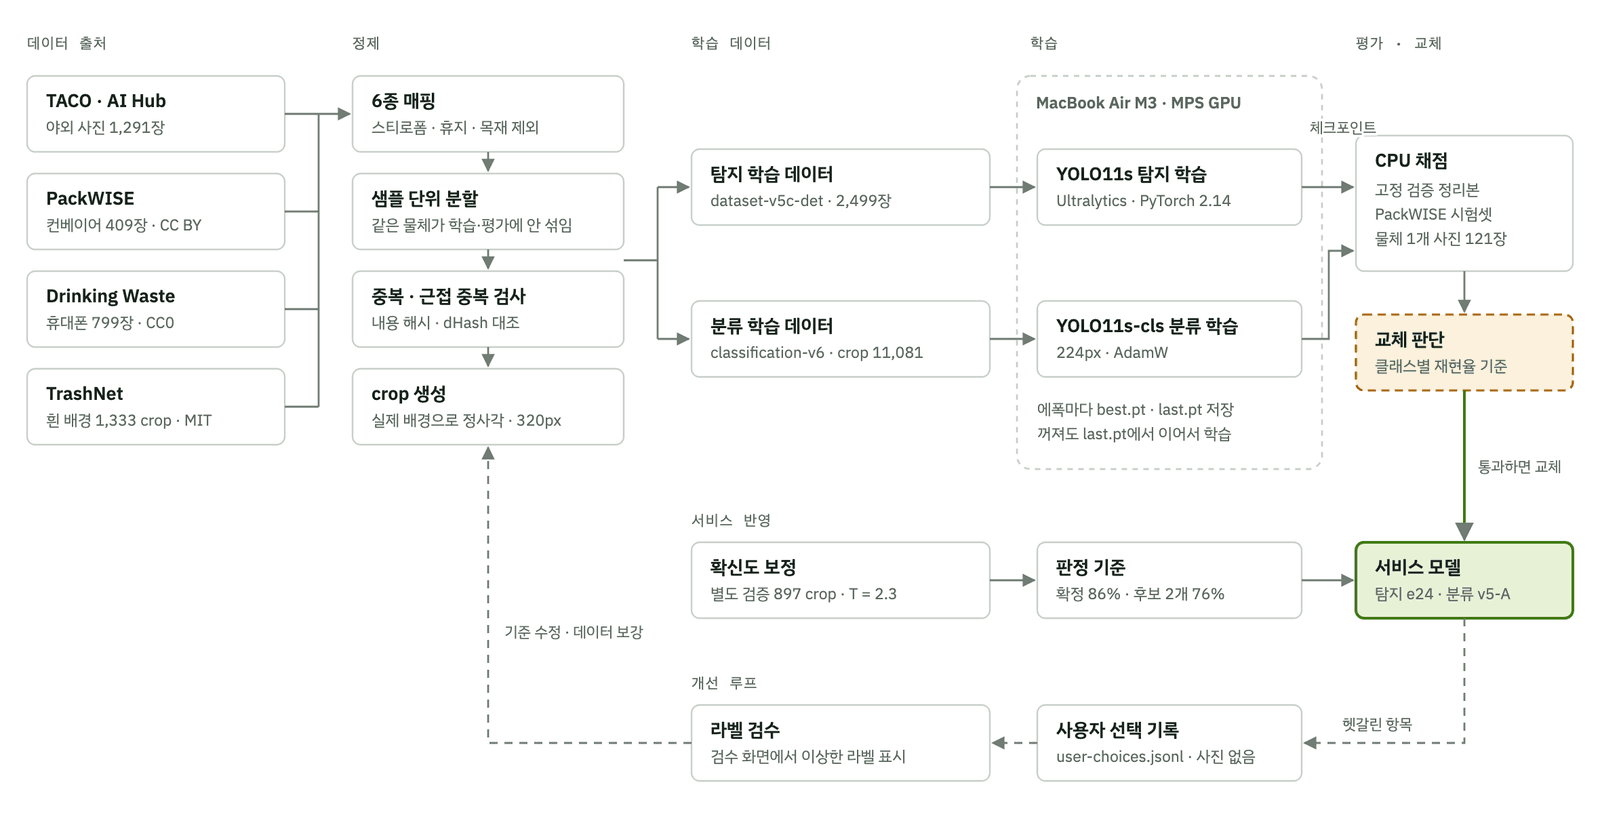
데이터는 야외 사진, 선별장 컨베이어, 휴대폰 촬영, 흰 배경 단독 촬영의 공개 데이터 4종을 씁니다. 촬영 환경이 모두 달라서, 가장 먼저 한 일은 기준을 하나로 맞추는 것이었습니다. 각 데이터의 원래 분류(최대 60종)를 6종으로 옮기면서, 6종에 넣기 애매한 휴지나 목재 같은 재질은 억지로 넣지 않고 뺐습니다.
기준은 한 번 정하고 끝나지 않았습니다. 라벨을 검수하다가 한 데이터는 스티로폼을 플라스틱 용기로, 다른 데이터는 제외로 처리하고 있다는 것을 발견했습니다. 원본 라벨과 박스 위치를 대조해 스티로폼 140개를 찾아 전부 제외하고, 변환 규칙에서도 지웠습니다. 다시 만들 때 섞여 들어오지 않게 하기 위해서입니다.
나눌 때는 사진 단위가 아니라 실물 샘플 단위로 나눕니다. 같은 물체를 연속 촬영한 사진이 학습과 평가에 나뉘어 들어가면 외운 것을 맞힌 점수가 나오기 때문입니다. 내용 해시와 지각 해시로 중복과 거의 같은 사진도 한 번 더 걸러냅니다.
학습은 맥북 GPU로, 채점은 CPU로 합니다. 같은 모델을 맥북 GPU로 두 번 채점하면 점수가 2%p 가까이 달랐고, 고해상도 사진에서는 10%p 넘게 벌어졌습니다. CPU는 소수점까지 같았습니다. 모델을 고르는 숫자는 반드시 다시 재도 같은 값이 나오는 곳에서 잽니다.
새 모델은 채점 결과가 좋아도 바로 넣지 않습니다. 박스 단위 점수에서는 앞섰지만 실제 서비스 흐름으로 돌리면 정답을 보여주는 사진이 4장 줄어든 경우가 있었고, 그때는 교체하지 않았습니다. 교체는 서비스 흐름 기준으로 좋아졌을 때만 합니다.
사진 한 장이 처리되는 과정
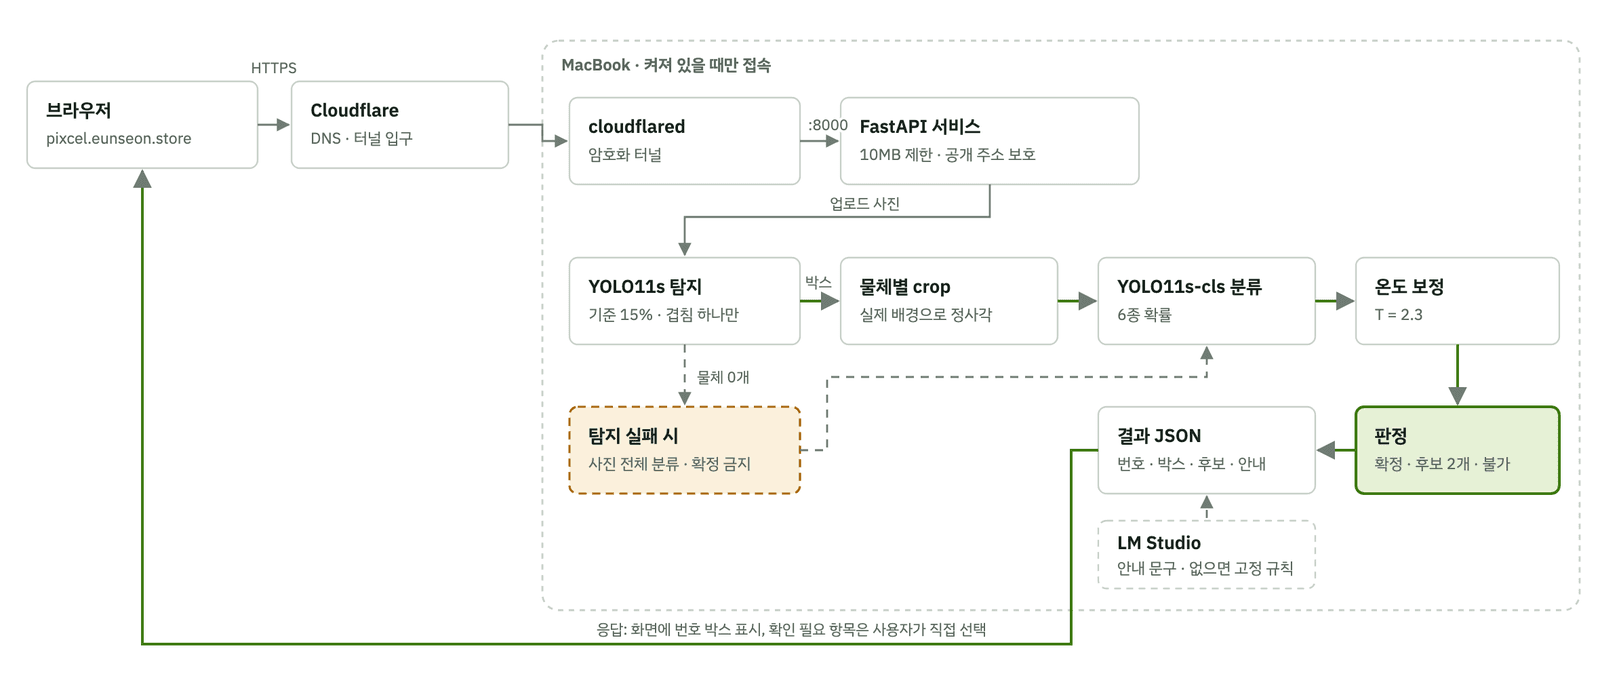
공개 주소로 들어온 사진은 Cloudflare를 거쳐 암호화된 터널로 맥북까지 옵니다. 맥북에 공인 IP를 열거나 공유기 포트를 설정할 필요가 없고, 도메인도 그대로 쓸 수 있습니다. 대신 맥북이 켜져 있을 때만 접속됩니다. 포트폴리오와 데모 용도라서 이 한계를 받아들였고, 계속 켜둬야 하면 같은 주소로 클라우드 서버에 옮기면 됩니다.
누구나 접속할 수 있는 주소라서 공개 주소로 들어온 요청에만 보호 장치를 걸었습니다. 10MB가 넘는 업로드는 거부하고, API 문서는 숨기고, 라벨 검수 기록은 쓸 수 없게 막았습니다. 같은 기능을 맥북 안에서는 그대로 쓸 수 있습니다.
서비스 안에서는 먼저 탐지 모델이 물체 위치를 찾습니다. 확신 기준은 15%로 낮게 두었습니다. 25%일 때 붙어 있는 쓰레기 속 플라스틱 컵이 24%로 잡혀 1%p 차이로 걸러지는 일이 있었기 때문입니다. 대신 같은 위치에 종류만 다른 박스가 겹치면 하나만 남깁니다. 종류는 어차피 다음 단계의 분류 모델이 다시 판정합니다.
찾은 물체는 하나씩 잘라서 분류 모델에 넣습니다. 이때 정사각형을 맞추려고 빈 곳을 회색으로 채우지 않고, 원본 사진의 실제 주변을 가져옵니다. 학습할 때와 같은 방식이어야 같은 성능이 나오기 때문입니다.
확신도를 믿기 전에 보정한다
분류 모델이 말하는 확신도는 실제보다 높았습니다. 평균 84%의 확신도로 답했지만 실제 정답률은 66%였습니다. 학습과 평가에 쓰지 않은 별도 데이터로 온도 값(2.3)을 하나 찾아 확신도를 낮춰 맞췄고, 보정 후 평균 확신도는 67%로 실제 정답률과 거의 같아졌습니다.
보정된 확신도로 나누는 세 가지 답
탐지 모델이 물체를 하나도 못 찾으면 사진 전체를 분류하는데, 이 경로에서는 확정을 금지했습니다. 분류 모델은 물체만 잘린 사진으로 배웠기 때문에 배경이 넓은 사진에서는 확정한 답 10건 중 1건만 맞았습니다. 틀린 답을 자신 있게 말하는 대신 후보 두 개를 보여줍니다.
사용자가 고른 답이 다시 데이터가 된다
후보 두 개가 나오거나 판별 불가일 때 사용자가 직접 종류를 고를 수 있습니다. 고르면 그 종류의 배출 방법이 바로 나오고, 모델이 낸 후보와 사람이 고른 답이 기록됩니다. 사진은 저장하지 않습니다. 첫날 기록에서 이미 모델이 플라스틱 병 70%라고 한 것을 사람이 유리로 고친 사례가 나왔습니다. 이런 기록이 쌓이면 모델이 무엇을 무엇으로 헷갈리는지가 드러나고, 그게 다음 라벨 검수와 데이터 보강의 순서가 됩니다.
아직 남은 한계
첫째, 모든 점수는 공개 데이터 기준입니다. 실제 설치 장소에서 찍은 사진으로는 아직 재지 않았습니다. 둘째, 맥북이 꺼지면 서비스도 멈춥니다. 셋째, 탐지와 분류에 쓴 학습 도구의 라이선스가 AGPL-3.0이라, 상업 납품 전에는 기업 라이선스를 쓸지, 소스를 공개할지, 다른 모델로 바꿀지 정해야 합니다.
정리
이 구조에서 모델은 한 칸일 뿐입니다. 데이터 기준을 맞추는 단계, 결과가 재현되는 채점, 확신도를 보정하는 단계, 애매할 때 사람에게 넘기는 판정, 사람이 고른 답을 다시 데이터로 돌리는 경로가 함께 있어야 서비스로 쓸 수 있습니다. 비용은 0원이지만, 각 칸을 왜 그렇게 두었는지는 모두 실험 기록으로 남겨 두었습니다.