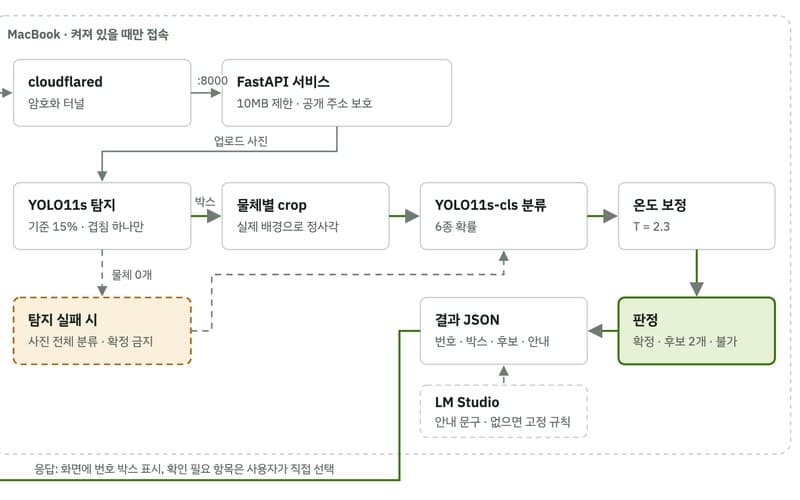
맥북 한 대로 운영하는 AI 비전 서비스의 구조
폐기물 사진을 6종으로 분류하는 AI 서비스를 별도 서버 없이 맥북과 Cloudflare Tunnel로 공개했습니다. 데이터가 모델이 되는 과정, 사진 한 장이 답이 되는 과정, 사용자가 고른 답이 다시 데이터가 되는 과정을 구조도와 함께 정리합니다.
8분 읽기 Contact Us →
INSIGHTS & KNOWLEDGE
마케팅 글이 아닙니다. 프로젝트에서 실제로 부딪힌 문제, 실험 결과, 실패 경험. 현장에서 배운 것을 그대로 씁니다.
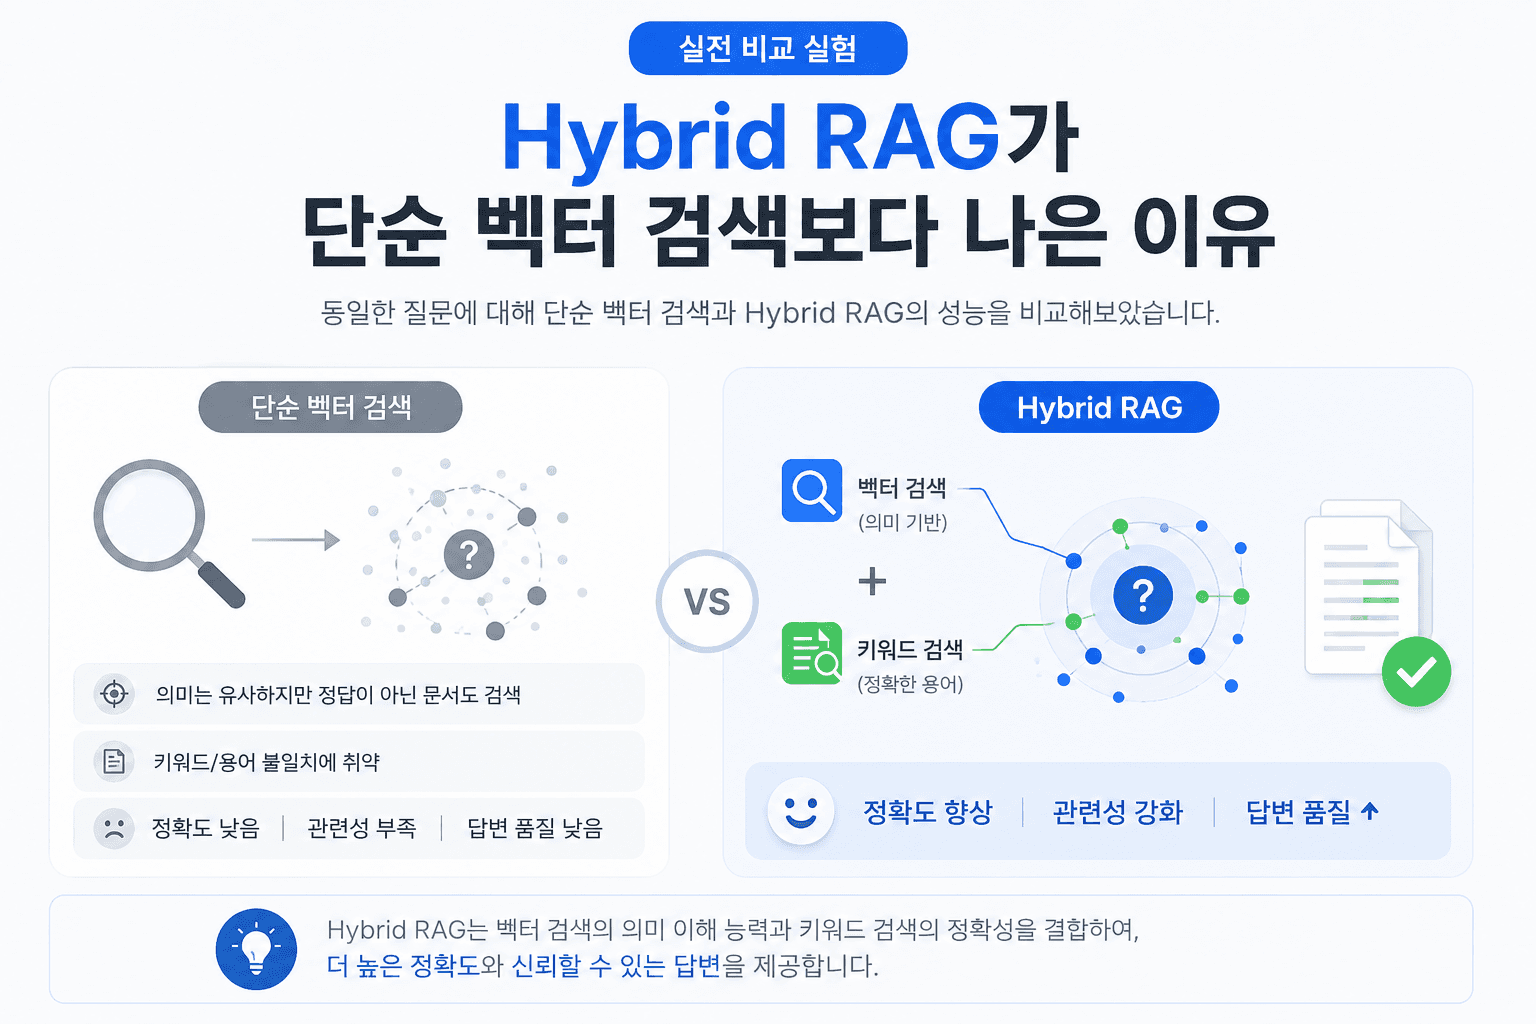
키워드 검색과 시맨틱 검색을 합치면 왜 더 나은가? 3가지 실험 케이스와 수치로 증명합니다. 기업 내부 문서 검색에서 Hybrid RAG가 정확도 23%p 향상을 기록한 이유.
폐기물 사진을 6종으로 분류하는 AI 서비스를 별도 서버 없이 맥북과 Cloudflare Tunnel로 공개했습니다. 데이터가 모델이 되는 과정, 사진 한 장이 답이 되는 과정, 사용자가 고른 답이 다시 데이터가 되는 과정을 구조도와 함께 정리합니다.
8분 읽기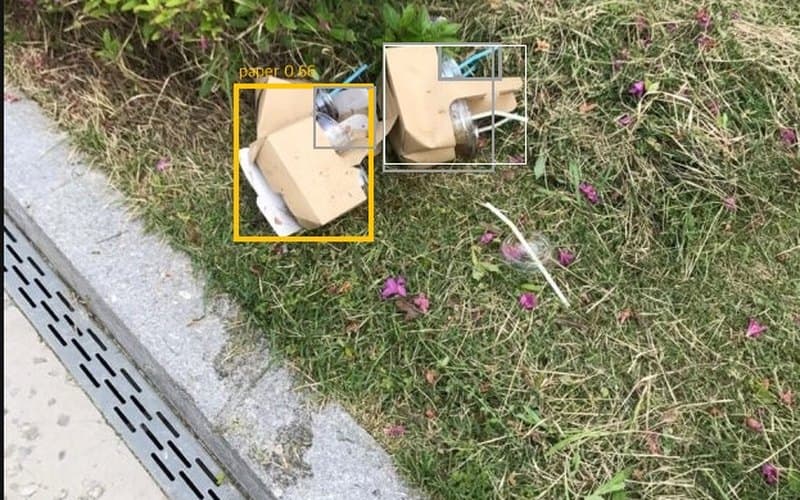
잘라낸 사진으로 잰 분류 정확도는 91%였지만, 같은 모델을 실제 서비스 흐름에 넣자 64%로 떨어졌습니다. 폐기물 사진 분류 서비스를 만들며 그 차이가 어디서 생기는지 하나씩 찾았고, 물체 1개 사진의 정답 표시 비율을 55.4%에서 71.9%로 올렸습니다. 대표 점수만 믿었다면 놓쳤을 네 가지를 정리합니다.
9분 읽기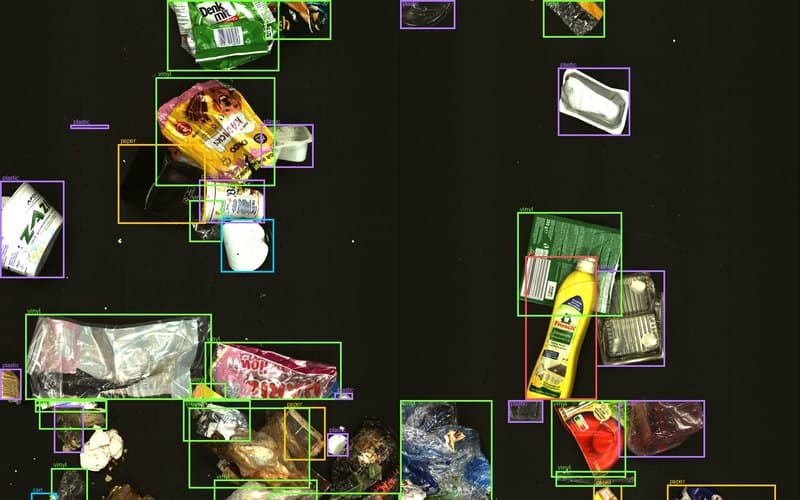
연구기관이 배포한 폐기물 데이터셋의 공식 test 분할에서, 실물 샘플 82개 중 56개가 train 분할에도 들어 있었습니다. 샘플 ID가 없는 다른 데이터에서는 정확도 99.7%라는 점수가 나왔습니다. 공개 데이터를 평가에 쓰기 전에 분할을 확인하는 방법을 실제 사례로 정리합니다.
7분 읽기
벤치마크가 아닌 실제 업무 케이스(법률 문서 분석, 코드 생성, 한국어 처리)에서 두 모델을 직접 비교했습니다. 각각 어떤 상황에서 우위를 보이는지 정리합니다.
12분 읽기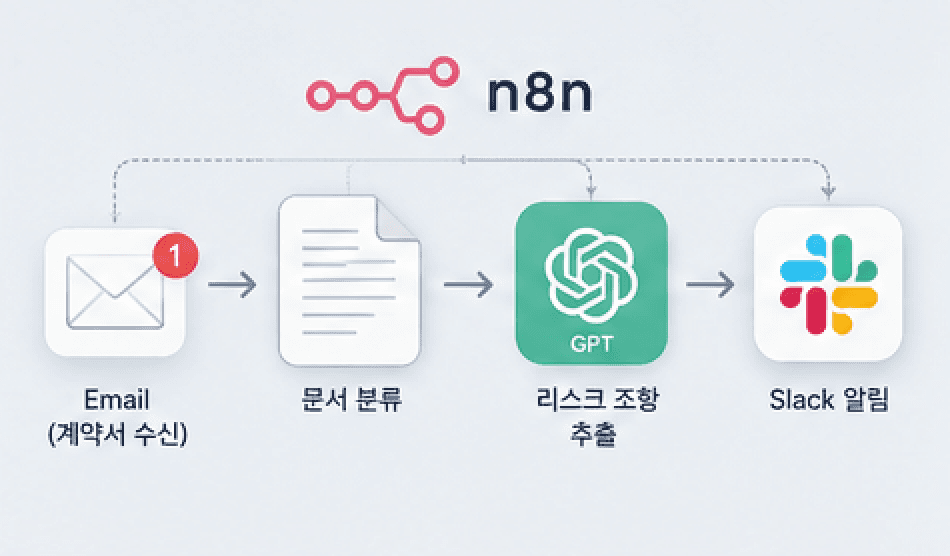
이메일로 들어오는 계약서를 자동 분류하고, GPT로 리스크 조항을 추출한 뒤 Slack으로 알림을 보내는 파이프라인을 n8n으로 구현하는 방법을 단계별로 설명합니다.
10분 읽기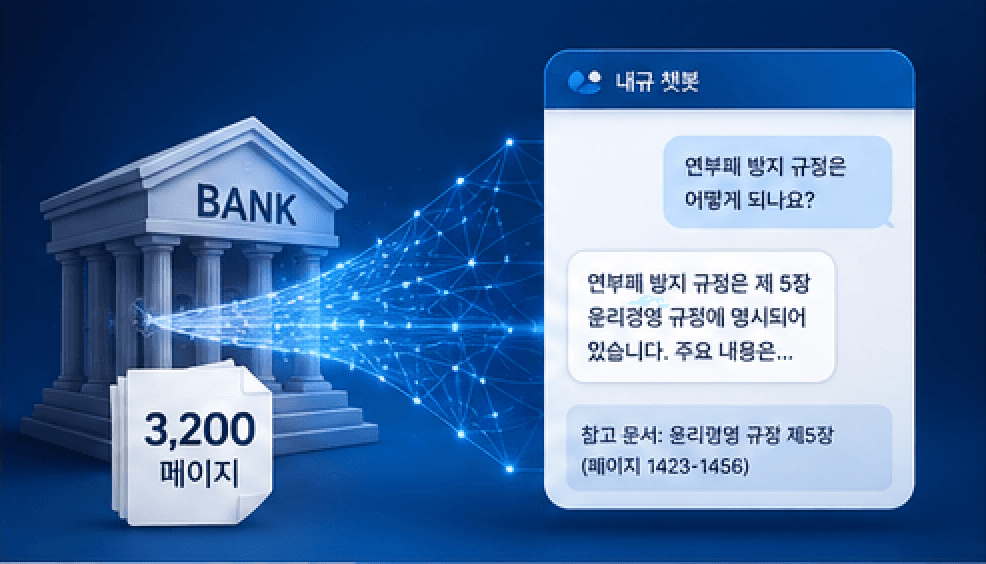
대형 은행 준법감시팀의 내규 문서 챗봇 프로젝트 전 과정을 공개합니다. 청킹 전략, 임베딩 모델 선택, 평가 지표 설정까지. 실제로 부딪힌 문제와 해결책을 솔직하게 씁니다.
15분 읽기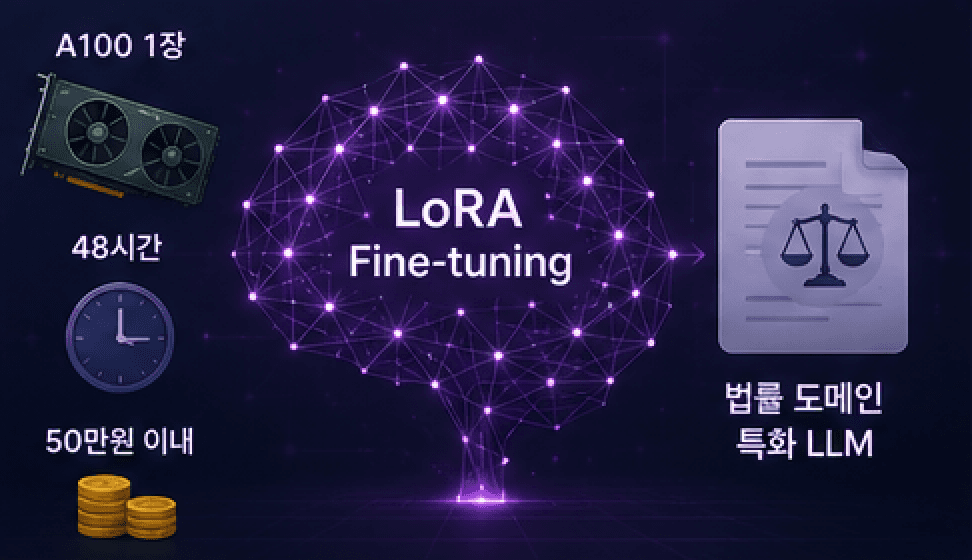
A100 한 장, 48시간, 50만 원 이내의 예산으로 법률 도메인 특화 LLM을 파인튜닝한 과정을 공유합니다. 하이퍼파라미터 선택, 데이터 품질 관리, 평가까지.
14분 읽기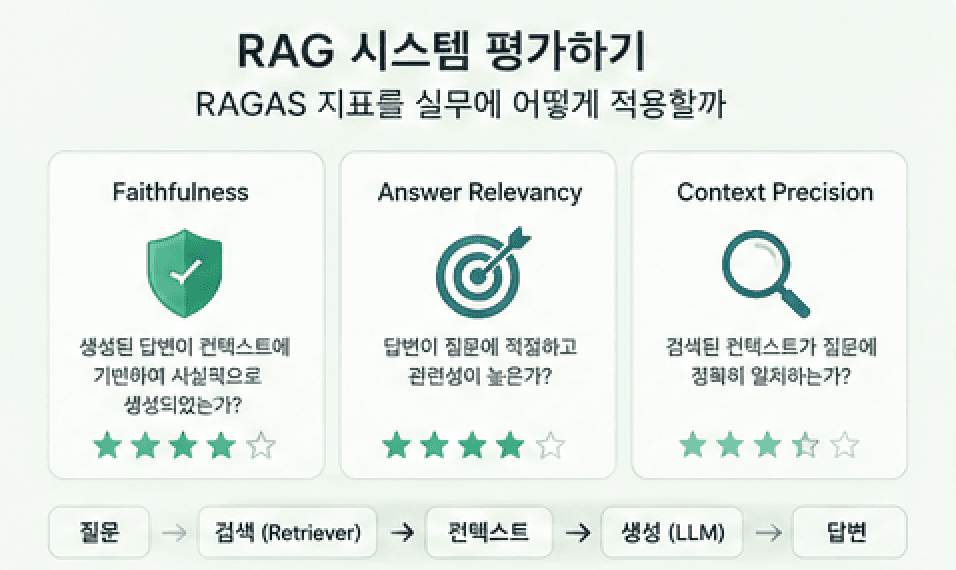
Faithfulness, Answer Relevancy, Context Precision. RAG 평가 지표들이 실제로 무엇을 측정하는지, 그리고 프로젝트에서 어떤 지표를 우선시해야 하는지 정리합니다.
11분 읽기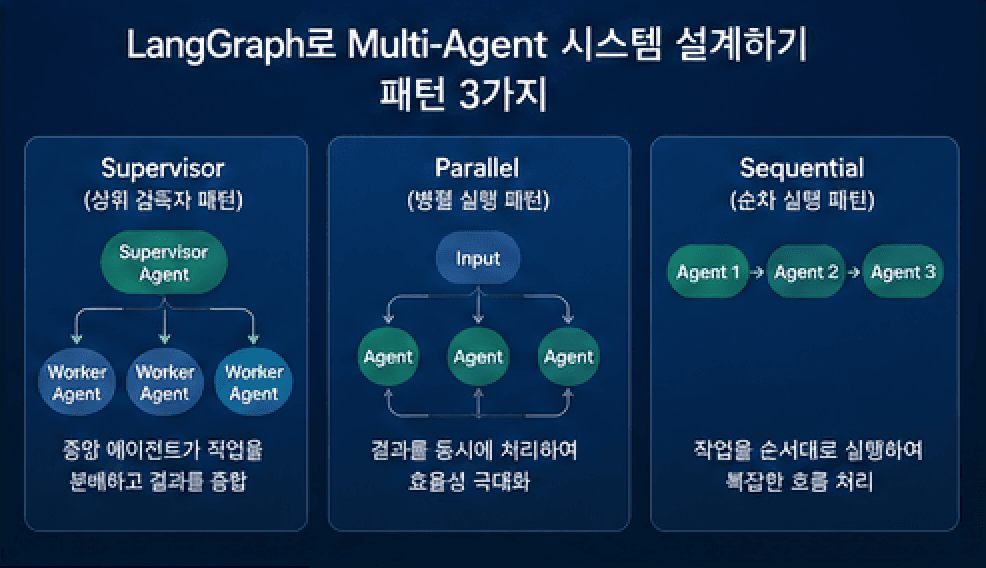
Supervisor, Parallel, Sequential. LangGraph에서 자주 쓰는 멀티에이전트 패턴 3가지를 실제 코드와 함께 설명합니다. 어떤 업무 흐름에 어떤 패턴이 맞는지.
13분 읽기STAY UPDATED