공개 데이터셋에 공식 train/test 분할이 제공되면 대부분 그대로 씁니다. 폐기물 사진 6종 분류 모델을 만들면서 두 개의 공개 데이터셋을 검사했고, 두 곳 모두 그대로 쓰면 성능이 부풀려지는 구조였습니다. 확인한 방법과 수치를 공유합니다.
왜 분할이 깨지는가
이미지 데이터의 상당수는 같은 피사체를 여러 번 촬영해서 만듭니다. 컨베이어 벨트를 연속 촬영하거나, 물건 하나를 각도를 바꿔 여러 장 찍는 식입니다. 이런 데이터를 이미지 단위로 무작위 분할하면, 같은 물체의 사진이 train과 test에 나뉘어 들어갑니다. 모델은 처음 보는 물체를 맞힌 게 아니라 이미 본 물체를 알아본 것이 되고, 점수는 실제 사용 환경보다 높게 나옵니다.
원칙은 간단합니다. 분할은 이미지가 아니라 촬영 단위(샘플, 세션, 피사체)로 해야 합니다. 문제는 그 단위가 데이터에 명시돼 있지 않은 경우가 많다는 점입니다.
사례 1: 샘플 번호가 있는 데이터
독일 프라운호퍼 연구소가 배포한 선별장 포장 폐기물 데이터셋(RGB 586장)은 공식 70/15/15 분할을 제공합니다. 파일명에 Probe 번호가 들어 있었고, 이것이 실물 샘플 번호입니다. 공식 분할별로 등장하는 샘플 번호를 대조했습니다.
공식 분할 간 샘플 중복 (각 분할의 샘플 82개 기준)
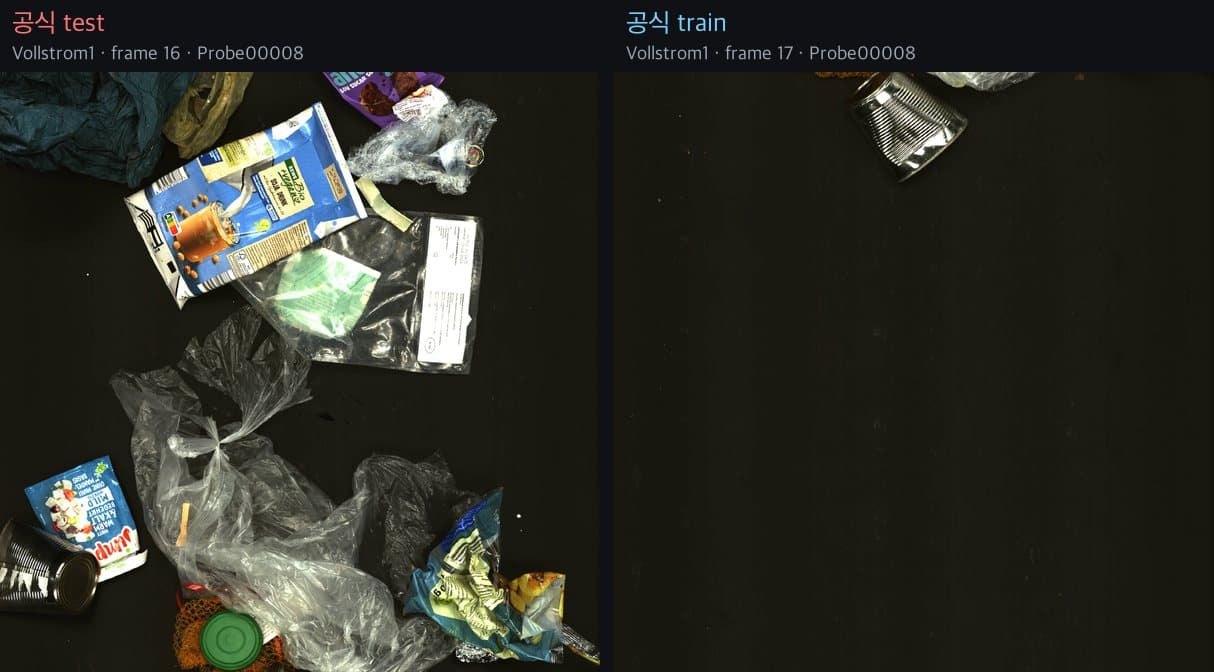
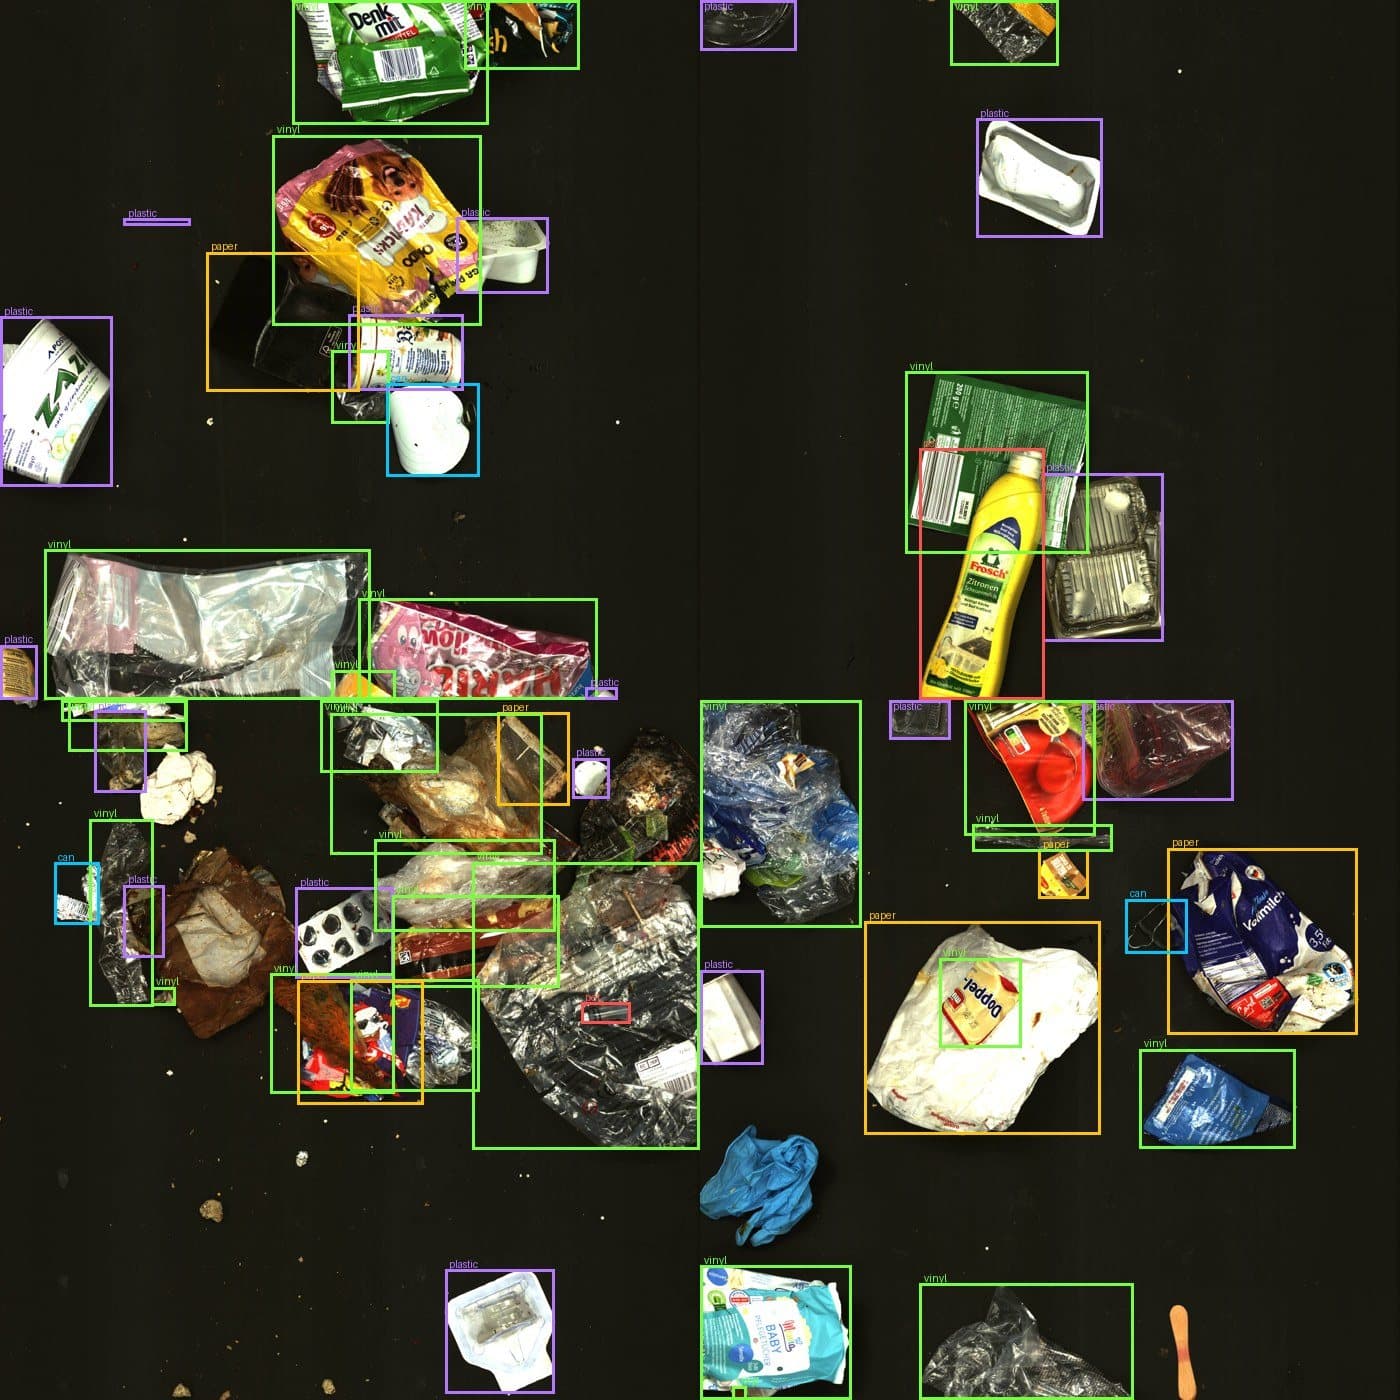
이 분할이 잘못됐다는 뜻은 아닙니다. 데이터셋의 원래 목적에 따라 프레임 단위 분할이 적절할 수도 있습니다. 다만 처음 보는 폐기물을 분류하는 능력을 재려는 목적에는 맞지 않습니다. 샘플 번호로 이미지를 묶어 그룹 단위로 70/15/15로 다시 나눴고, 재분할 후 분할 간 샘플 중복은 0건이 됐습니다.
사례 2: 샘플 번호가 없는 데이터
음료 용기 사진 4,816장(휴대폰 촬영)으로 구성된 다른 공개 데이터셋에는 샘플 정보가 없습니다. 이미지 단위로 무작위 분할해 평가했더니 정확도 99.7%가 나왔습니다. 같은 모델이 다른 평가셋에서는 66~72%였으니, 이 숫자는 성과가 아니라 점검 신호였습니다.
먼저 내용 해시로 중복을 찾았습니다. 완전히 같은 이미지는 4장뿐이었습니다. 지각 해시(dHash)로 거의 같은 이미지까지 넓혀 16.5%를 찾아 제외했지만, 다시 채점해도 99.7%였습니다. 해시 기반 검사로는 각도와 조명이 조금씩 다른 연속 촬영 사진을 걸러낼 수 없었습니다.
단서는 파일명의 일련번호였습니다. 같은 물체를 연속으로 찍으면 번호가 이어집니다. 평가 이미지마다 같은 클래스의 학습 이미지 중 번호가 가장 가까운 것과의 간격을 계산했습니다.
평가 이미지와 가장 가까운 학습 이미지의 번호 간격
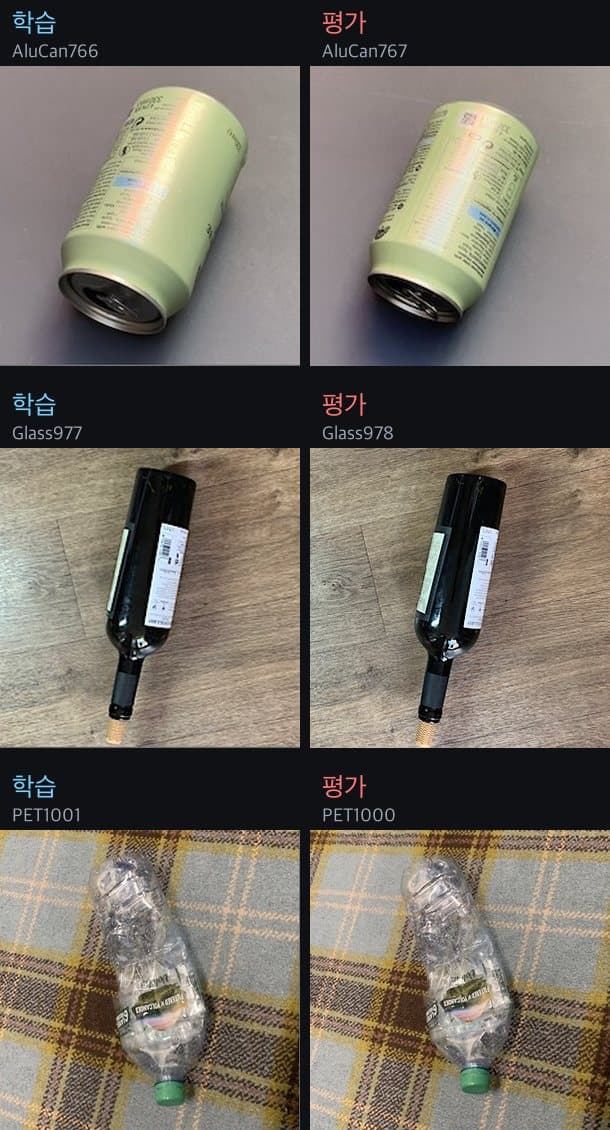
평가 이미지의 98.8%가 바로 옆 번호의 학습 이미지를 갖고 있었습니다. 이 데이터는 촬영 단위를 복원할 방법이 없어 분할을 고쳐도 해결되지 않습니다. 학습에만 쓰고 평가에서는 제외했습니다. 흰 배경에 물체를 하나씩 놓고 찍은 또 다른 공개 데이터셋도 같은 구조였고(97.2%), 같은 조치를 했습니다.
공개 데이터를 평가에 쓰기 전에 확인할 것
1. 파일명과 메타데이터에 샘플, 세션, 촬영자, 시각 같은 그룹 정보가 있는지 봅니다. 있다면 그 단위로 분할이 나뉘어 있는지 대조합니다.
2. 그룹 정보가 없다면 일련번호나 촬영 시각의 간격 분포를 봅니다. 평가 이미지 대부분이 학습 이미지와 인접 번호라면 연속 촬영 누수입니다.
3. 해시 중복 검사만으로 끝내지 않습니다. 완전 동일 이미지는 4장이었지만 실제 누수는 98.8%였습니다.
4. 같은 모델의 평가셋별 점수 차이를 봅니다. 특정 평가셋만 비정상적으로 높다면 모델보다 분할을 먼저 의심합니다.
5. 그룹 단위를 복원할 수 없는 데이터는 평가에서 제외합니다. 평가셋 개수가 줄어도 신뢰할 수 없는 점수를 남기는 것보다 낫습니다.
정리
이번 프로젝트에서 신뢰할 수 있는 평가셋은 처음 4개에서 2개로 줄었습니다. 대신 남은 점수는 설명할 수 있습니다. 야외 사진 평가셋은 62.5%에서 66.4%로, 샘플 단위로 재분할한 컨베이어 평가셋은 46.1%에서 72.5%로 올랐습니다. 공개 데이터셋의 공식 분할은 출발점이지, 검증이 끝난 기준이 아닙니다.