지난 글에서는 평가 데이터의 누수를 걷어냈습니다. 이번에는 그 모델을 실제 서비스에 넣으면서 겪은 일을 정리합니다. 사진 속 폐기물을 찾고 6종으로 분류하는 서비스에서, 물체 1개짜리 사진의 정답 표시 비율을 55.4%에서 71.9%로 올렸습니다. 과정에서 대표 점수를 믿었다면 잘못 판단했을 순간이 네 번 있었습니다.
1. 대표 점수가 올랐는데 학습을 멈췄다
탐지 모델이 병목이었습니다. 물체를 못 찾으면 분류할 기회도 없기 때문입니다. 유리와 캔 사진을 늘리려고 휴대폰으로 찍은 음료 용기 사진을 학습 데이터의 66%까지 넣고 다시 학습했습니다.
11에폭에서 대표 점수인 mAP50이 시작 모델의 24.4%를 넘어 25.6%가 됐습니다. 그런데 클래스별로 뜯어보니 플라스틱 병 하나가 48.9%에서 57.4%로 오르며 평균을 끌어올린 것이었습니다. 물체를 찾아낸 비율(재현율)은 오히려 계속 떨어지고 있었습니다.
11에폭 시점, 시작 모델 대비 재현율
휴대폰 사진은 대부분 화면 가운데 큰 물체 하나였고, 실제 사진의 쓰레기는 작고 다른 쓰레기와 섞여 있었습니다. 모델이 확실한 것만 박스를 치고 작은 물체는 더 놓치는 쪽으로 배우고 있었습니다. 목표가 놓치는 물체를 줄이는 것이었으므로 학습을 멈췄습니다.
휴대폰 사진을 32%로 줄이고, 이미 배운 가중치를 흔들지 않도록 학습률을 낮게 시작해 다시 학습했습니다. 이번에는 첫 에폭부터 mAP50 31.1%, 재현율 40.9%로 두 값이 함께 올랐습니다. 판정 기준도 처음부터 mAP50이 아니라 클래스별 재현율로 정해두었습니다.
2. 같은 모델을 두 번 채점했더니 점수가 달랐다
모델 네 개를 클래스별로 비교하다가 이상한 점을 발견했습니다. 이전에 24.4%로 쟀던 모델이 이번에는 23.0%로 나왔습니다. 같은 모델을 맥북 GPU로 연달아 두 번 채점하자 22.47%와 24.29%가 나왔습니다. CPU로 두 번 채점하자 두 번 모두 24.402%로 소수점까지 같았습니다.
같은 탐지 모델, 채점 장치별 결과
특히 4096픽셀 고해상도 이미지로 된 평가셋에서는 차이가 10%p를 넘었습니다. GPU 결과만 보고 새 모델이 기존 모델보다 물체를 덜 찾는다고 판단했는데, CPU로 다시 재자 반대로 더 많이 찾고 있었습니다. 이후로는 모델을 고르거나 서비스에 넣을지 정하는 점수는 모두 CPU로 재고, 학습 중 GPU 점수는 흐름을 보는 용도로만 씁니다.
3. 모델이 말하는 확신도는 실제보다 높았다
분류 모델은 야외 사진에서 평균 84.1%의 확신도로 답했지만 실제 정답률은 66.4%였습니다. 확신도가 높은 답만 골라 보여주는 기능이 제대로 작동할 수 없는 상태였습니다. 모델을 다시 학습하지 않고, 확신도를 나누는 값(온도)을 하나 찾아 뒤에서 조정했습니다. 이 값은 학습에도 평가에도 쓰지 않은 별도 데이터로 정했습니다.
확신도 보정 (야외 사진 470장)
보정 후에는 확신도 86% 이상만 확정하고, 1위와 2위를 합쳐 76% 이상이면 후보 두 개를 보여주고, 나머지는 판별 불가로 처리했습니다. 정확도 66%라는 숫자를, 확정해서 답한 것은 91% 맞고 사진의 77%에는 답한다는 설명으로 바꿀 수 있게 됐습니다.
4. 잘라낸 사진에서 91%, 실제 서비스에서는 64%
분류 모델 점수는 물체만 잘라낸 사진으로 잰 값입니다. 실제 서비스는 사진을 받아 탐지하고, 잘라내고, 분류하고, 판정합니다. 학습에 쓰지 않은 검증 사진 중 물체가 1개뿐인 121장을 서비스 API에 그대로 넣어 채점했더니 확정 정확도가 64%였습니다.
물체 1개 사진 121장, 경로별 확정 정확도
물체가 하나뿐인 사진인데도 탐지 모델이 36%를 못 찾았고, 그때 사진 전체를 분류하면 거의 틀린 답을 확정으로 내놓았습니다. 분류 모델은 물체만 잘린 사진으로 배웠기 때문에 배경이 넓은 사진은 처음 보는 형태였습니다. 이 경로에서는 확정을 금지하고 후보 두 개만 보여주도록 바꿨습니다.
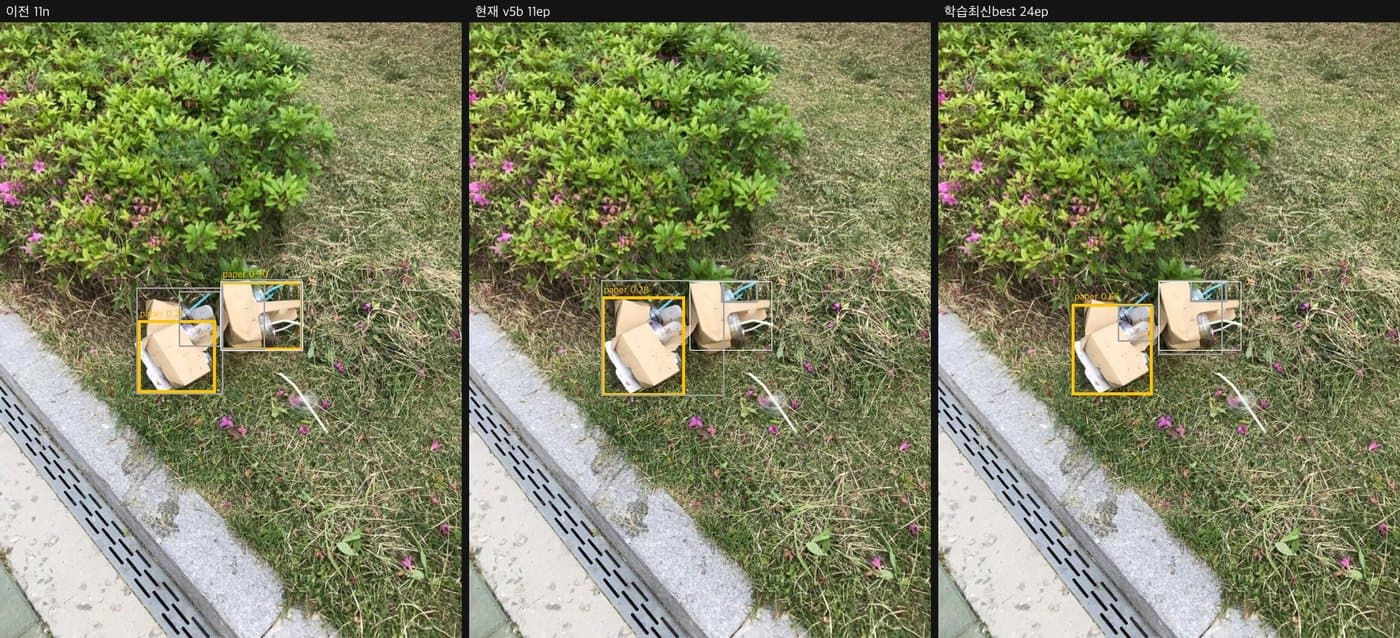
새 탐지 모델로 바꾸자 사용자가 이상한 점을 알려줬습니다. 이전에는 붙어 있는 쓰레기에 종이 또는 비닐이라는 두 후보가 나왔는데, 이제는 종이만 나온다는 것이었습니다. 확인해 보니 새 모델은 오른쪽 플라스틱 컵을 24%로 잡았고, 서비스는 25% 이상만 쓰고 있었습니다. 기준을 15%로 낮추고, 같은 위치에 종류만 다른 박스가 겹치면 하나만 남기도록 했습니다. 종류는 어차피 분류 모델이 다시 판정하기 때문입니다.
물체 1개 사진 121장, 정답을 보여준 비율
아직 남은 문제: 종이
탐지 모델의 종합 점수는 고정 검증셋에서 20.4%에서 35.9%로, 고해상도 평가셋에서 16.5%에서 46.1%로 올랐습니다. 하지만 종이는 여전히 약합니다. 원인을 나눠 보니 학습 데이터 양 문제는 아니었습니다. 종이 박스는 1,046개로 캔이나 유리보다 많았습니다.
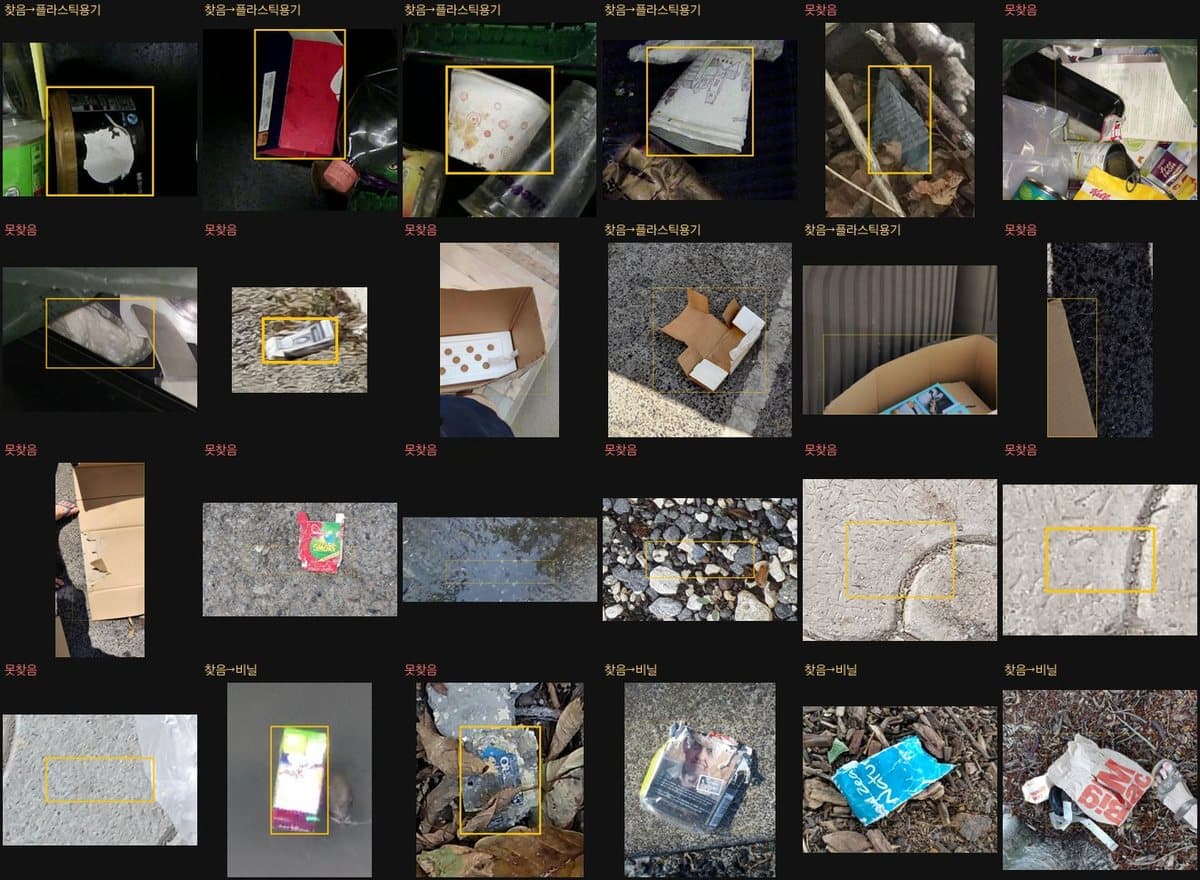
종이는 위치를 찾은 비율이 54%로 다른 클래스와 비슷했습니다. 문제는 찾아놓고 다른 종류로 이름을 붙인 비율이 28%로 가장 높다는 점이었습니다. 코팅된 종이컵은 플라스틱 용기로, 광택 있는 포장지는 비닐로 판정했습니다. 사진만으로는 사람도 헷갈리는 경계입니다. 놓친 종이는 크기 중앙값이 화면의 1.3%로, 찾은 종이 5.5%보다 훨씬 작았습니다.
정리
첫째, 목표에 맞는 지표로 판단하십시오. 놓치지 않는 것이 목표라면 mAP가 아니라 클래스별 재현율을 봐야 합니다. 둘째, 채점 결과가 재현되는지 먼저 확인하십시오. 같은 모델을 두 번 재서 다른 숫자가 나오면 그 차이로는 아무것도 결정할 수 없습니다. 셋째, 모델 단위가 아니라 서비스 흐름 전체로 재십시오. 잘라낸 사진 91%와 실제 서비스 64% 사이의 차이는 모델 밖에서 생겼습니다.
이번 개선의 상당 부분은 모델 구조를 바꿔서가 아니라 판정 방식, 학습 데이터의 성격, 서비스 흐름의 약한 고리를 찾아서 얻었습니다. 대표 점수 하나로는 이 중 어느 것도 보이지 않았습니다.